
ECDF + Kolmogorov-Smirnov
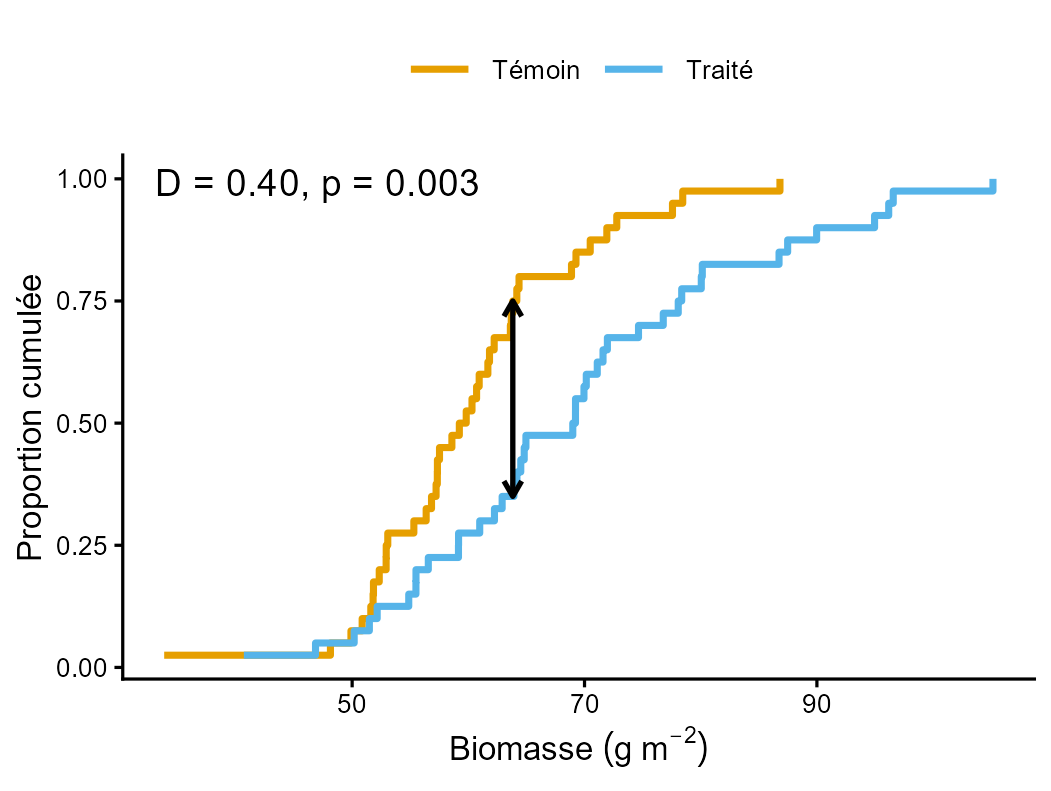
La fonction de répartition de chaque groupe, en escalier : le plus grand écart vertical entre deux courbes est la statistique D du test de Kolmogorov-Smirnov, qui compare les distributions entières.
1.Définition
La figure
La fonction de répartition de chaque groupe, en escalier : le plus grand écart vertical entre deux courbes est la statistique D du test de Kolmogorov-Smirnov, qui compare les distributions entières.
L’analyse statistique : Distributions
Une statistique descriptive complète d’une ou plusieurs mesures, par groupe si vous en donnez un : position, dispersion, forme de la distribution, normalité, et comparaison des distributions entières entre groupes par Kolmogorov-Smirnov.
2.Lancer l’analyse
Les étapes de « Nouvelle analyse », dans l’ordre : ce que chacune demande, et pourquoi.
Étape 1 : Choisir la figure
Ouvrez « Nouvelle analyse », famille « Décrire » du ruban, puis cette figure.
Pourquoi : Chaque figure a ses propres options : la choisir d’abord fixe celles qui la font et masque celles des autres figures.
Étape 2 : Importer les données
Un fichier CSV, TXT ou Excel (.xlsx, .xls) de 50 Mo et 200 000 lignes au plus, ou « Utiliser le jeu d’exemple » : sur lui, la figure est gratuite.
Pourquoi : Le fichier est lu dans votre navigateur : seules les colonnes que vous choisirez partiront au calcul, et elles sont effacées du serveur au bout de 24 h.
Étape 3 : Vérifier le type des colonnes
Chaque colonne est reconnue numérique, catégorielle ou texte ; un clic sur son type le change.
Pourquoi : Le rôle qu’une colonne peut prendre dépend de son type : un facteur codé 1, 2, 3 doit passer en catégorielle pour être lu comme des groupes.
Étape 4 : Attribuer les rôles
Dites ce que représente chaque colonne, et ce que la figure vous demande :
- Une ou plusieurs variables numériques
- Une variable de groupe
Pourquoi : Les rôles disent au moteur ce qui est mesuré, ce qui l’explique et ce qui groupe les observations : la même table répond à des questions différentes selon eux.
Étape 5 : Régler les options
Les options qui font cette figure sont déjà fixées. Restent :
- Variable de groupe (facultative) : Une courbe, une crête ou un panneau par groupe. Sans groupe, la figure décrit toute la mesure ; avec, elle les compare et le moteur ajoute le test de Kolmogorov-Smirnov par paire.
- Trait à la moyenne ou à la médiane : La moyenne pour une mesure symétrique, la médiane quand la distribution est asymétrique (revenus, abondances).
- Classes de l’histogramme : Freedman-Diaconis par défaut, qui s’adapte à la dispersion ; 10 à 50 classes à la main pour comparer plusieurs figures à la même résolution.
- Ajustement des p-values (Holm, Benjamini-Hochberg, aucun) : Plusieurs tests à la fois multiplient les faux positifs. Holm protège contre toute erreur (prudent) ; Benjamini-Hochberg contrôle la part de fausses découvertes (adapté à beaucoup de variables) ; aucun seulement pour un test isolé.
Pourquoi : Les valeurs par défaut sont les conventions des revues ; ne les changez que pour une raison que vous sauriez écrire dans votre section Méthodes.
Étape 6 : Lancer le calcul
Gratuit et complet sur le jeu d’exemple. Sur vos données : 5 crédits débités au lancement ; sans assez de crédits, un aperçu flouté, à débloquer pour 5 crédits.
Pourquoi : Le calcul est fait par R sur nos serveurs, et vous suivez ses étapes. S’il échoue, les crédits sont rendus.
Étape 7 : Lire les résultats
Les tableaux, l’interprétation en français ou en anglais et le paragraphe « Méthodes » prêt pour votre manuscrit.
Pourquoi : Chaque chiffre vient de R, et chaque phrase est un modèle rempli avec eux, jamais un texte inventé : vérifiez-les avec les tableaux.
Étape 8 : Télécharger la figure
PNG 300 DPI, PDF, EPS ou SVG, à 89 ou 183 mm ; les textes se modifient dans l’éditeur de figure.
Pourquoi : 89 mm est la largeur d’une colonne de revue, 183 mm celle d’une page : la figure est mise en page pour chacune, rien ne s’y chevauche.
3.Pourquoi et quand l’utiliser
Quand l’utiliser
Pour savoir si deux groupes ont la même distribution dans son ensemble, et pas seulement la même moyenne : décalage, étalement ou queue différente.
Exemple de question : Les distributions de longueur diffèrent-elles d’un élevage à l’autre, et pas seulement leur moyenne ?
Ce que les résultats montrent
- La forme de la mesure : symétrique ou asymétrique, un ou plusieurs modes, valeurs extrêmes.
- Si une moyenne la résume bien, ou s’il vaut mieux parler de médiane.
- Avec des groupes : en quoi leurs distributions diffèrent (position, étalement, queues).
4.Méthode et packages R
Ce que le moteur R exécute pour cette figure : les packages, les fonctions principales, les étapes du calcul et les formules.
Packages R
- stats
- ggplot2
- ggrepel
shapiro.test(y) · ks.test(y₁, y₂)
Fonctions principales
| Fonction | Package | Rôle |
|---|---|---|
| shapiro.test | stats | normalité de chaque groupe |
| ks.test | stats | comparaison de deux distributions |
| density | stats | courbes de densité (noyau gaussien) |
| quantile (type 7) | stats | quartiles et EIQ |
| ggplot | ggplot2 | la figure |
Ce que fait le script, dans l’ordre
- Lit chaque variable, retire les valeurs manquantes et compte celles retirées.
- Calcule pour chaque variable et chaque groupe : n, moyenne, écart type, erreur type, IC 95 % de la moyenne, médiane, quartiles, min, max, EIQ, coefficient de variation, asymétrie G1 et aplatissement G2.
- Teste la normalité de chaque groupe par Shapiro-Wilk (3 à 5 000 valeurs).
- Compare chaque paire de groupes par Kolmogorov-Smirnov (jusqu’à 6 groupes), p ajustées.
- Dessine la figure : densités, crêtes et piles de points calculées par le moteur, puis ggplot2.
Formules principales
Asymétrie G1
G1 = √(n(n − 1)) / (n − 2) · m₃ / m₂^(3/2)
m₂ et m₃ sont les moments centrés d’ordre 2 et 3. G1 > 0 : queue à droite ; G1 < 0 : queue à gauche ; |G1| < 0,5 : à peu près symétrique.
Densité par noyau
f̂(x) = 1/(n·h) · Σ K((x − xᵢ)/h), K gaussien, h de Silverman
La courbe lissée de l’histogramme : chaque valeur apporte une petite cloche de largeur h. Les bosses sont les modes.
Kolmogorov-Smirnov à deux échantillons
D = max |F₁(x) − F₂(x)|
F₁ et F₂ sont les fonctions de répartition des deux groupes. D est le plus grand écart vertical entre les deux escaliers ; p < α, les distributions diffèrent dans leur ensemble.
Normalité (Shapiro-Wilk)
W = (Σ aᵢ x₍ᵢ₎)² / Σ (xᵢ − x̄)²
x₍ᵢ₎ sont les valeurs triées, aᵢ des poids tirés de la loi normale. W proche de 1 : données compatibles avec une loi normale ; p < 0,05 : écart à la normalité.
À citer
- Shapiro, S. S. & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3-4), 591-611. doi:10.1093/biomet/52.3-4.591 (nouvel onglet)
5.Données d’entrée
Une ligne par observation (un poisson, une parcelle), une colonne numérique par mesure et, si vous comparez, une colonne de groupe.
Ce que la figure demande
- Une ou plusieurs variables numériques
- Une variable de groupe
Format : CSV, TXT ou Excel, une ligne d’en-tête avec le nom des colonnes. La virgule ou le point décimal, le séparateur et l’encodage sont reconnus seuls ; une case vide est une valeur manquante.
Le jeu d’exemple : Taille des tilapias d’élevage
Rôles : Longueur_cm, une fonction de répartition par Elevage, Kolmogorov-Smirnov deux à deux.
6.Prix
5crédits
par lancement sur vos données. Chaque figure coûte 5 crédits, quelle qu’elle soit : la figure, ses tableaux, son interprétation et ses téléchargements sont compris.
| Pack | Prix du pack | Cette figure |
|---|---|---|
| Starter (50 crédits) | 500 FCFA | 50 FCFA |
| Standard (250 crédits) | 2 000 FCFA | 40 FCFA |
| Pro (700 crédits) | 5 000 FCFA | 36 FCFA |
- Gratuite sur son jeu d’exemple (tilapias_elevage.csv), résultats complets : pour la découvrir avant d’importer vos données.
- Sur vos données sans assez de crédits, elle se lance quand même en aperçu flouté, débloqué ensuite pour 5 crédits sans relancer le calcul.
- Si le calcul échoue, les crédits sont rendus.
- Paiement par mobile money ; voir les packs.
Lancer « ECDF + Kolmogorov-Smirnov » sur vos données
Ou ouvrez-la gratuitement avec son jeu d’exemple pour voir chaque étape et des résultats complets avant d’importer votre fichier.