
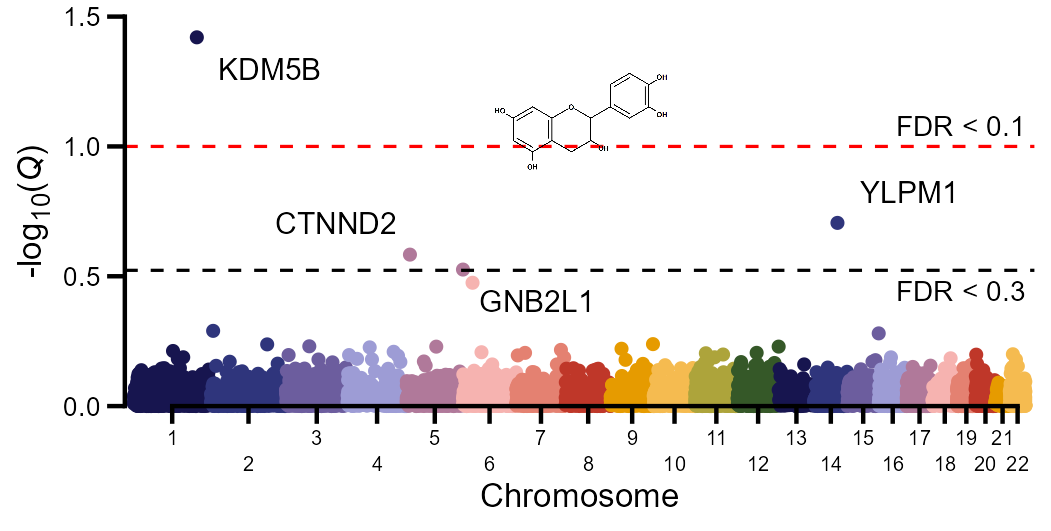
Manhattan + encart sur le pic
Les marqueurs le long du génome à la hauteur du −log10 de leur valeur Q (FDR), une couleur par chromosome : les seuils FDR 0.1 (rouge) et 0.3 nommés au bout de leur ligne, les marqueurs sous 0.3 nommés, et en encart un zoom sur les quelques mégabases autour du pic le plus fort.
Expression des gènes (omique) · Manhattan plot (GWAS) · 5 crédits
Lancer cette figure (nouvel onglet)1.Définition
La figure
Les marqueurs le long du génome à la hauteur du −log10 de leur valeur Q (FDR), une couleur par chromosome : les seuils FDR 0.1 (rouge) et 0.3 nommés au bout de leur ligne, les marqueurs sous 0.3 nommés, et en encart un zoom sur les quelques mégabases autour du pic le plus fort.
L’analyse statistique : Manhattan plot (GWAS)
Le Manhattan plot d’une étude d’association pangénomique : chaque marqueur (SNP) le long des chromosomes, à la hauteur de −log10 p. Les pics au-dessus du seuil génomique sont les locus associés au caractère.
2.Lancer l’analyse
Les étapes de « Nouvelle analyse », dans l’ordre : ce que chacune demande, et pourquoi.
Étape 1 : Choisir la figure
Ouvrez « Nouvelle analyse », famille « Omique » du ruban, puis cette figure.
Pourquoi : Chaque figure a ses propres options : la choisir d’abord fixe celles qui la font et masque celles des autres figures.
Étape 2 : Importer les données
Un fichier CSV, TXT ou Excel (.xlsx, .xls) de 50 Mo et 200 000 lignes au plus, ou « Utiliser le jeu d’exemple » : sur lui, la figure est gratuite.
Pourquoi : Le fichier est lu dans votre navigateur : seules les colonnes que vous choisirez partiront au calcul, et elles sont effacées du serveur au bout de 24 h.
Étape 3 : Vérifier le type des colonnes
Chaque colonne est reconnue numérique, catégorielle ou texte ; un clic sur son type le change.
Pourquoi : Le rôle qu’une colonne peut prendre dépend de son type : un facteur codé 1, 2, 3 doit passer en catégorielle pour être lu comme des groupes.
Étape 4 : Attribuer les rôles
Dites ce que représente chaque colonne, et ce que la figure vous demande :
- Une ligne par marqueur ou gène : son chromosome, sa position (pb) et sa valeur Q (FDR), ou sa p-value brute, ajustée ici
- Facultatif : le nom de chaque gène, écrit sur la figure
Pourquoi : Les rôles disent au moteur ce qui est mesuré, ce qui l’explique et ce qui groupe les observations : la même table répond à des questions différentes selon eux.
Étape 5 : Régler les options
Les options qui font cette figure sont déjà fixées. Restent :
- Seuil génomique : 5 × 10⁻⁸, 10⁻⁸ ou Bonferroni : 5 × 10⁻⁸ est la convention humaine ; Bonferroni (0,05 / marqueurs) s’adapte à votre nombre de marqueurs.
- p brutes ou Q-values : Des Q-values déjà ajustées sont lues telles quelles, avec les lignes FDR 0,1 et 0,3 (figure en encart).
Pourquoi : Les valeurs par défaut sont les conventions des revues ; ne les changez que pour une raison que vous sauriez écrire dans votre section Méthodes.
Étape 6 : Lancer le calcul
Gratuit et complet sur le jeu d’exemple. Sur vos données : 5 crédits débités au lancement ; sans assez de crédits, un aperçu flouté, à débloquer pour 5 crédits.
Pourquoi : Le calcul est fait par R sur nos serveurs, et vous suivez ses étapes. S’il échoue, les crédits sont rendus.
Étape 7 : Lire les résultats
Les tableaux, l’interprétation en français ou en anglais et le paragraphe « Méthodes » prêt pour votre manuscrit.
Pourquoi : Chaque chiffre vient de R, et chaque phrase est un modèle rempli avec eux, jamais un texte inventé : vérifiez-les avec les tableaux.
Étape 8 : Télécharger la figure
PNG 300 DPI, PDF, EPS ou SVG, à 89 ou 183 mm ; les textes se modifient dans l’éditeur de figure.
Pourquoi : 89 mm est la largeur d’une colonne de revue, 183 mm celle d’une page : la figure est mise en page pour chacune, rien ne s’y chevauche.
3.Pourquoi et quand l’utiliser
Quand l’utiliser
Quand peu de marqueurs passent les seuils (des gènes testés contre un métabolite, un petit panel) : nommer chacun et montrer de près le voisinage du plus fort, comme dans l’article.
Exemple de question : Quels gènes du théier sont associés à la teneur des feuilles en catéchines, et où se trouvent-ils ?
Ce que les résultats montrent
- Les régions du génome associées au caractère (pics au-dessus de 5 × 10⁻⁸ ou du seuil choisi).
- L’inflation génomique λ, qui dit si les p sont gonflées par la structure de population.
4.Méthode et packages R
Ce que le moteur R exécute pour cette figure : les packages, les fonctions principales, les étapes du calcul et les formules.
Packages R
- stats
- ggpp
- ggrepel
- ggplot2
−log10 p ~ chromosome : position · p < 5 × 10⁻⁸ · λ = médiane(χ²) / 0.455
Fonctions principales
| Fonction | Package | Rôle |
|---|---|---|
| p.adjust, qchisq | stats | Q-values et λ |
| annotate("plot_npc") | ggpp | l’encart |
| geom_text_repel | ggrepel | noms des marqueurs |
Ce que fait le script, dans l’ordre
- Lit chromosome, position et p (PLINK, GEMMA, GAPIT, TASSEL), range les chromosomes.
- Calcule les Q-values (BH) et l’inflation λ.
- Place les chromosomes bout à bout, nomme le meilleur marqueur de chaque pic.
- Pour l’encart : zoom sur le pic le plus fort (ggpp).
Formules principales
Inflation génomique
λ = médiane(χ²₁ des p) / 0,455
λ ≈ 1 : pas d’inflation ; λ > 1,1 : structure de population ou parenté mal prises en compte.
Benjamini-Hochberg (FDR)
q₍ᵢ₎ = min(1, min_{j≥i} m·p₍ⱼ₎ / j)
Sur m tests triés par p : parmi les éléments retenus à q < α, la part attendue de faux positifs reste sous α.
À citer
- Pe’er, I., Yelensky, R., Altshuler, D. & Daly, M. J. (2008). Estimation of the multiple testing burden for genomewide association studies of nearly all common variants. Genetic Epidemiology, 32(4), 381-385. doi:10.1002/gepi.20303 (nouvel onglet)
- Devlin, B. & Roeder, K. (1999). Genomic control for association studies. Biometrics, 55(4), 997-1004. doi:10.1111/j.0006-341X.1999.00997.x (nouvel onglet)
- Benjamini, Y. & Hochberg, Y. (1995). Controlling the false discovery rate: a practical and powerful approach to multiple testing. Journal of the Royal Statistical Society, Series B, 57(1), 289-300. doi:10.1111/j.2517-6161.1995.tb02031.x (nouvel onglet)
- Wickham, H. (2016). ggplot2: elegant graphics for data analysis. Springer (Use R!), 2ᵉ éd.. doi:10.1007/978-3-319-24277-4 (nouvel onglet)
5.Données d’entrée
Une ligne par marqueur : chromosome, position, p (ou Q-value) et nom en option ; 20 à 500 000 lignes.
Ce que la figure demande
- Une ligne par marqueur ou gène : son chromosome, sa position (pb) et sa valeur Q (FDR), ou sa p-value brute, ajustée ici
- Facultatif : le nom de chaque gène, écrit sur la figure
Format : CSV, TXT ou Excel, une ligne d’en-tête avec le nom des colonnes. La virgule ou le point décimal, le séparateur et l’encodage sont reconnus seuls ; une case vide est une valeur manquante.
Le jeu d’exemple : Gènes du théier et catéchines
Rôles : 3 000 gènes (geneSymbol) placés par chr et position, la valeur Q (FDR) de leur lien aux catéchines.
6.Prix
5crédits
par lancement sur vos données. Chaque figure coûte 5 crédits, quelle qu’elle soit : la figure, ses tableaux, son interprétation et ses téléchargements sont compris.
| Pack | Prix du pack | Cette figure |
|---|---|---|
| Starter (50 crédits) | 500 FCFA | 50 FCFA |
| Standard (250 crédits) | 2 000 FCFA | 40 FCFA |
| Pro (700 crédits) | 5 000 FCFA | 36 FCFA |
- Gratuite sur son jeu d’exemple (genes_catechine_the.csv), résultats complets : pour la découvrir avant d’importer vos données.
- Sur vos données sans assez de crédits, elle se lance quand même en aperçu flouté, débloqué ensuite pour 5 crédits sans relancer le calcul.
- Si le calcul échoue, les crédits sont rendus.
- Paiement par mobile money ; voir les packs.
Lancer « Manhattan + encart sur le pic » sur vos données
Ou ouvrez-la gratuitement avec son jeu d’exemple pour voir chaque étape et des résultats complets avant d’importer votre fichier.