
Moyennes ± erreur en X et Y
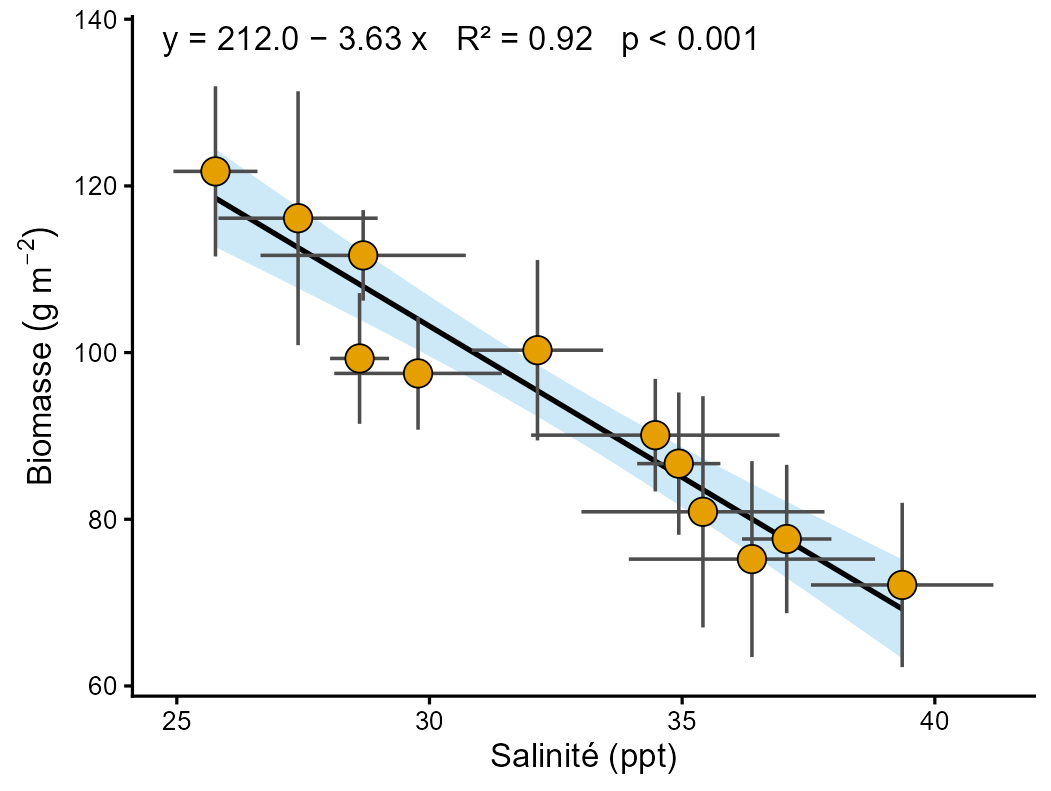
Une moyenne par groupe, ses barres d’erreur sur les deux axes, et la régression qui passe par les moyennes : la tendance entre stations, sites ou lots.
1.Définition
La figure
Une moyenne par groupe, ses barres d’erreur sur les deux axes, et la régression qui passe par les moyennes : la tendance entre stations, sites ou lots.
L’analyse statistique : Corrélation et régression
Mesure la force et le sens du lien entre des variables numériques (Pearson, Spearman ou Kendall), et ajuste en option une régression de Y sur X : droite, polynôme, loess ou rupture de pente.
2.Lancer l’analyse
Les étapes de « Nouvelle analyse », dans l’ordre : ce que chacune demande, et pourquoi.
Étape 1 : Choisir la figure
Ouvrez « Nouvelle analyse », famille « Relations » du ruban, puis cette figure.
Pourquoi : Chaque figure a ses propres options : la choisir d’abord fixe celles qui la font et masque celles des autres figures.
Étape 2 : Importer les données
Un fichier CSV, TXT ou Excel (.xlsx, .xls) de 50 Mo et 200 000 lignes au plus, ou « Utiliser le jeu d’exemple » : sur lui, la figure est gratuite.
Pourquoi : Le fichier est lu dans votre navigateur : seules les colonnes que vous choisirez partiront au calcul, et elles sont effacées du serveur au bout de 24 h.
Étape 3 : Vérifier le type des colonnes
Chaque colonne est reconnue numérique, catégorielle ou texte ; un clic sur son type le change.
Pourquoi : Le rôle qu’une colonne peut prendre dépend de son type : un facteur codé 1, 2, 3 doit passer en catégorielle pour être lu comme des groupes.
Étape 4 : Attribuer les rôles
Dites ce que représente chaque colonne, et ce que la figure vous demande :
- La variable à expliquer (Y) et la variable explicative (X)
- Une variable de groupe : un point par groupe
Pourquoi : Les rôles disent au moteur ce qui est mesuré, ce qui l’explique et ce qui groupe les observations : la même table répond à des questions différentes selon eux.
Étape 5 : Régler les options
Les options qui font cette figure sont déjà fixées. Restent :
- Pearson, Spearman ou Kendall : Pearson pour un lien linéaire entre mesures normales ; Spearman pour un lien monotone ou des données asymétriques ; Kendall sur de petits effectifs avec des ex æquo.
- Type de régression : Linéaire par défaut ; quadratique ou cubique pour une courbe ; loess pour une tendance sans équation ; rupture pour un seuil (pluie au-delà de laquelle le rendement plafonne).
- Ajustement des p-values (Holm, Benjamini-Hochberg, aucun) : Beaucoup de paires testées à la fois multiplient les faux positifs : Holm (défaut) protège contre toute erreur, Benjamini-Hochberg contrôle la part de fausses découvertes.
Pourquoi : Les valeurs par défaut sont les conventions des revues ; ne les changez que pour une raison que vous sauriez écrire dans votre section Méthodes.
Étape 6 : Lancer le calcul
Gratuit et complet sur le jeu d’exemple. Sur vos données : 5 crédits débités au lancement ; sans assez de crédits, un aperçu flouté, à débloquer pour 5 crédits.
Pourquoi : Le calcul est fait par R sur nos serveurs, et vous suivez ses étapes. S’il échoue, les crédits sont rendus.
Étape 7 : Lire les résultats
Les tableaux, l’interprétation en français ou en anglais et le paragraphe « Méthodes » prêt pour votre manuscrit.
Pourquoi : Chaque chiffre vient de R, et chaque phrase est un modèle rempli avec eux, jamais un texte inventé : vérifiez-les avec les tableaux.
Étape 8 : Télécharger la figure
PNG 300 DPI, PDF, EPS ou SVG, à 89 ou 183 mm ; les textes se modifient dans l’éditeur de figure.
Pourquoi : 89 mm est la largeur d’une colonne de revue, 183 mm celle d’une page : la figure est mise en page pour chacune, rien ne s’y chevauche.
3.Pourquoi et quand l’utiliser
Quand l’utiliser
Quand on raisonne à l’échelle des sites, stations ou lots plutôt que des mesures individuelles : la tendance entre moyennes, avec leur incertitude.
Exemple de question : D’un département à l’autre, le rendement moyen suit-il le carbone moyen ?
Ce que les résultats montrent
- Quelles variables varient ensemble, et dans quel sens (matrice, réseau).
- Avec la régression : l’équation, le R², la pente et son IC, la bande de confiance à 95 %.
- Les diagnostics : résidus, normalité, points influents (distance de Cook).
4.Méthode et packages R
Ce que le moteur R exécute pour cette figure : les packages, les fonctions principales, les étapes du calcul et les formules.
Packages R
- stats
- car
- ggcorrplot
- igraph
- ggraph
cor.test(x, y, method = "pearson") · lm(y ~ x)
Fonctions principales
| Fonction | Package | Rôle |
|---|---|---|
| cor.test | stats | chaque paire |
| lm, loess | stats | régressions |
| ncvTest | car | variance constante |
| ggcorrplot | ggcorrplot | la matrice |
| graph_from_data_frame, ggraph | igraph, ggraph | le réseau |
Ce que fait le script, dans l’ordre
- Garde les lignes complètes sur toutes les variables utilisées (même n partout).
- Teste chaque paire par cor.test, p ajustées sur l’ensemble.
- Ajuste la régression demandée, vérifie normalité des résidus et variance constante (Breusch-Pagan).
- Dessine la matrice, le nuage et sa droite, le réseau des liens forts ou les diagnostics.
Formules principales
Coefficient de Pearson
r = Σ (xᵢ − x̄)(yᵢ − ȳ) / √(Σ (xᵢ − x̄)² · Σ (yᵢ − ȳ)²)
Entre −1 et 1 : le signe dit le sens du lien, |r| sa force (Evans : < 0,2 très faible, < 0,4 faible, < 0,6 modérée, < 0,8 forte). Testé par t = r √((n − 2)/(1 − r²)).
Coefficient de Spearman
ρ = Pearson calculé sur les rangs de x et de y
Mesure un lien monotone (toujours croissant ou décroissant), même non linéaire, et résiste aux valeurs extrêmes.
Régression linéaire
y = β₀ + β₁x + ε ; R² = 1 − SC_résiduelle / SC_totale
β₁ est le changement de y pour une unité de x ; R² la part de la variation de y expliquée par x.
Distance de Cook
Dᵢ = Σⱼ (ŷⱼ − ŷⱼ₍₋ᵢ₎)² / (p · CM_résiduel)
De combien les prédictions bougent quand on retire le point i : Dᵢ > 4/n, point influent (en rouge).
À citer
- Benjamini, Y. & Hochberg, Y. (1995). Controlling the false discovery rate: a practical and powerful approach to multiple testing. Journal of the Royal Statistical Society, Series B, 57(1), 289-300. doi:10.1111/j.2517-6161.1995.tb02031.x (nouvel onglet)
- Ward, J. H. (1963). Hierarchical grouping to optimize an objective function. Journal of the American Statistical Association, 58(301), 236-244. doi:10.1080/01621459.1963.10500845 (nouvel onglet)
5.Données d’entrée
Une ligne par observation, 2 à 20 colonnes numériques ; au moins 10 lignes complètes.
Ce que la figure demande
- La variable à expliquer (Y) et la variable explicative (X)
- Une variable de groupe : un point par groupe
Format : CSV, TXT ou Excel, une ligne d’en-tête avec le nom des colonnes. La virgule ou le point décimal, le séparateur et l’encodage sont reconnus seuls ; une case vide est une valeur manquante.
Le jeu d’exemple : Sols et rendement d’arachide
Rôles : La moyenne de Rendement_kgha et de Carbone_gkg de chaque Departement.
6.Prix
5crédits
par lancement sur vos données. Chaque figure coûte 5 crédits, quelle qu’elle soit : la figure, ses tableaux, son interprétation et ses téléchargements sont compris.
| Pack | Prix du pack | Cette figure |
|---|---|---|
| Starter (50 crédits) | 500 FCFA | 50 FCFA |
| Standard (250 crédits) | 2 000 FCFA | 40 FCFA |
| Pro (700 crédits) | 5 000 FCFA | 36 FCFA |
- Gratuite sur son jeu d’exemple (sols_arachide.csv), résultats complets : pour la découvrir avant d’importer vos données.
- Sur vos données sans assez de crédits, elle se lance quand même en aperçu flouté, débloqué ensuite pour 5 crédits sans relancer le calcul.
- Si le calcul échoue, les crédits sont rendus.
- Paiement par mobile money ; voir les packs.
Lancer « Moyennes ± erreur en X et Y » sur vos données
Ou ouvrez-la gratuitement avec son jeu d’exemple pour voir chaque étape et des résultats complets avant d’importer votre fichier.