
Régression logistique + ROC
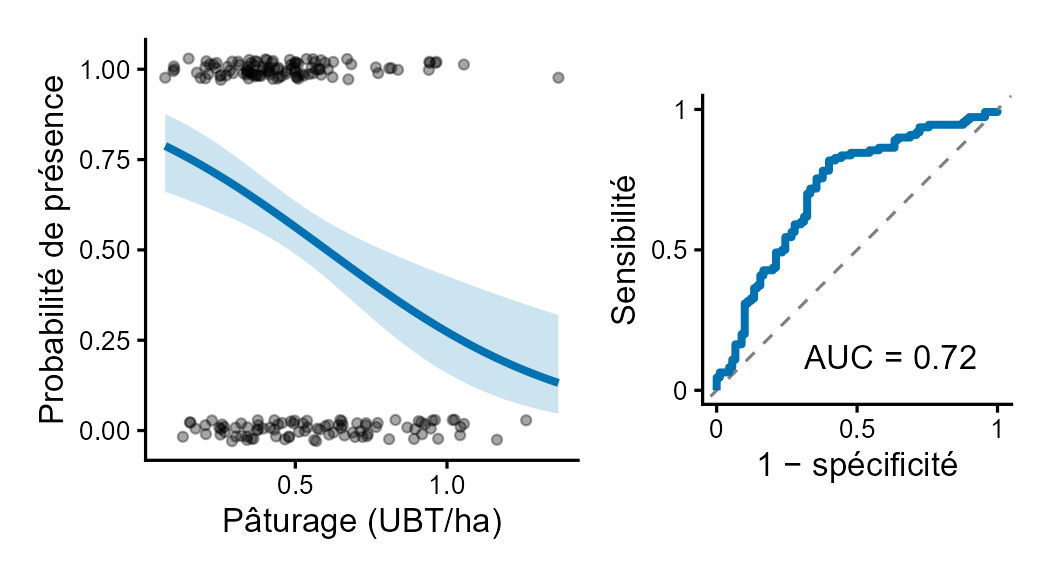
La probabilité de l’événement selon chaque prédicteur, avec sa bande de confiance, et la courbe ROC du modèle avec son AUC.
Expliquer une variable (régressions) · Régression multiple et GLM · 5 crédits
Lancer cette figure (nouvel onglet)1.Définition
La figure
La probabilité de l’événement selon chaque prédicteur, avec sa bande de confiance, et la courbe ROC du modèle avec son AUC.
L’analyse statistique : Régression multiple et GLM
La régression multiple et ses extensions (GLM, GLMM) expliquent une réponse par plusieurs prédicteurs, avec la loi qui convient aux valeurs : normale, binomiale (0/1), Poisson ou binomiale négative (comptages), Gamma (mesures positives).
2.Lancer l’analyse
Les étapes de « Nouvelle analyse », dans l’ordre : ce que chacune demande, et pourquoi.
Étape 1 : Choisir la figure
Ouvrez « Nouvelle analyse », famille « Régressions » du ruban, puis cette figure.
Pourquoi : Chaque figure a ses propres options : la choisir d’abord fixe celles qui la font et masque celles des autres figures.
Étape 2 : Importer les données
Un fichier CSV, TXT ou Excel (.xlsx, .xls) de 50 Mo et 200 000 lignes au plus, ou « Utiliser le jeu d’exemple » : sur lui, la figure est gratuite.
Pourquoi : Le fichier est lu dans votre navigateur : seules les colonnes que vous choisirez partiront au calcul, et elles sont effacées du serveur au bout de 24 h.
Étape 3 : Vérifier le type des colonnes
Chaque colonne est reconnue numérique, catégorielle ou texte ; un clic sur son type le change.
Pourquoi : Le rôle qu’une colonne peut prendre dépend de son type : un facteur codé 1, 2, 3 doit passer en catégorielle pour être lu comme des groupes.
Étape 4 : Attribuer les rôles
Dites ce que représente chaque colonne, et ce que la figure vous demande :
- Une variable 0/1 à expliquer
- Les prédicteurs (1 à 12)
Pourquoi : Les rôles disent au moteur ce qui est mesuré, ce qui l’explique et ce qui groupe les observations : la même table répond à des questions différentes selon eux.
Étape 5 : Régler les options
Les options qui font cette figure sont déjà fixées. Restent :
- Loi : automatique ou imposée : Automatique (recommandé) d’après la nature de la réponse : 0/1 → binomiale, comptages → Poisson ou binomiale négative selon la surdispersion, mesures positives → normale ou Gamma.
- Prédicteurs centrés-réduits : Par défaut : les coefficients deviennent comparables entre variables d’unités différentes.
- Effets aléatoires (0 à 2) : Pour des observations groupées (sites, années) : le modèle devient un GLMM.
Pourquoi : Les valeurs par défaut sont les conventions des revues ; ne les changez que pour une raison que vous sauriez écrire dans votre section Méthodes.
Étape 6 : Lancer le calcul
Gratuit et complet sur le jeu d’exemple. Sur vos données : 5 crédits débités au lancement ; sans assez de crédits, un aperçu flouté, à débloquer pour 5 crédits.
Pourquoi : Le calcul est fait par R sur nos serveurs, et vous suivez ses étapes. S’il échoue, les crédits sont rendus.
Étape 7 : Lire les résultats
Les tableaux, l’interprétation en français ou en anglais et le paragraphe « Méthodes » prêt pour votre manuscrit.
Pourquoi : Chaque chiffre vient de R, et chaque phrase est un modèle rempli avec eux, jamais un texte inventé : vérifiez-les avec les tableaux.
Étape 8 : Télécharger la figure
PNG 300 DPI, PDF, EPS ou SVG, à 89 ou 183 mm ; les textes se modifient dans l’éditeur de figure.
Pourquoi : 89 mm est la largeur d’une colonne de revue, 183 mm celle d’une page : la figure est mise en page pour chacune, rien ne s’y chevauche.
3.Pourquoi et quand l’utiliser
Quand l’utiliser
Pour modéliser une probabilité (de présence, de germination, de survie) selon quelques prédicteurs et évaluer le modèle par sa courbe ROC.
Exemple de question : Le pâturage réduit-il la probabilité de trouver Acacia, et le modèle classe-t-il bien les placettes ?
Ce que les résultats montrent
- L’effet de chaque prédicteur, à autres variables constantes (coefficient, IC, test de type II).
- Pour une loi logit ou log : les rapports de cotes ou de taux, exp(β).
- La part de chaque prédicteur dans ce qu’explique le modèle (partition hiérarchique).
4.Méthode et packages R
Ce que le moteur R exécute pour cette figure : les packages, les fonctions principales, les étapes du calcul et les formules.
Packages R
- stats
- MASS
- lme4
- lmerTest
- car
- emmeans
- pROC
glm(y ~ x₁ + x₂, family) · glmer(… + (1 | site))
Fonctions principales
| Fonction | Package | Rôle |
|---|---|---|
| glm | stats | GLM |
| glm.nb | MASS | binomiale négative |
| glmer, lmer | lme4, lmerTest | GLMM et modèle mixte |
| Anova, vif | car | tests de type II, colinéarité |
| emmeans | emmeans | effets prédits |
Ce que fait le script, dans l’ordre
- Reconnaît la nature de la réponse et choisit la loi.
- Ajuste glm, glm.nb, glmer ou lmer ; tests de type II (rapport de vraisemblance, F ou Wald).
- Calcule les IC par profil, R², D², McFadden, Tjur, AUC ; vérifie surdispersion, colinéarité (VIF), séparation.
- Partition hiérarchique du R² ou du D² (valeurs de Shapley sur les 2^k sous-modèles).
- Dessine coefficients, importance, effets prédits (emmeans), résidus quantiles ou effets aléatoires.
Formules principales
Modèle linéaire généralisé
g(E[y]) = β₀ + β₁x₁ + … + βₖxₖ
g est la fonction de lien : identité (normale), logit (binomiale), log (Poisson, Gamma). β se lit sur l’échelle du lien.
Rapport de cotes
OR = exp(β)
En logit : une unité de x multiplie la cote de l’événement par OR. OR > 1, il le rend plus probable.
Déviance expliquée
D² = 1 − déviance résiduelle / déviance nulle
L’équivalent du R² pour un GLM.
R² de Nakagawa
R²m = σ²_f / (σ²_f + Σσ²_a + σ²_ε) ; R²c = (σ²_f + Σσ²_a) / (σ²_f + Σσ²_a + σ²_ε)
σ²_f est la variance due aux effets fixes, σ²_a celle des effets aléatoires, σ²_ε la résiduelle. R² marginal : ce qu’expliquent vos prédicteurs ; conditionnel : avec les groupes en plus.
À citer
- Nelder, J. A. & Wedderburn, R. W. M. (1972). Generalized linear models. Journal of the Royal Statistical Society, Series A, 135(3), 370-384. doi:10.2307/2344614 (nouvel onglet)
- Bates, D., Mächler, M., Bolker, B. & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1-48. doi:10.18637/jss.v067.i01 (nouvel onglet)
- Dunn, P. K. & Smyth, G. K. (1996). Randomized quantile residuals. Journal of Computational and Graphical Statistics, 5(3), 236-244. doi:10.1080/10618600.1996.10474708 (nouvel onglet)
- Lai, J., Zou, Y., Zhang, S., Zhang, X. & Mao, L. (2022). glmm.hp: an R package for computing individual effect of predictors in generalized linear mixed models. Journal of Plant Ecology, 15(6), 1302-1307. doi:10.1093/jpe/rtac096 (nouvel onglet)
- Kleiber, C. & Zeileis, A. (2016). Visualizing count data regressions using rootograms. The American Statistician, 70(3), 296-303. doi:10.1080/00031305.2016.1173590 (nouvel onglet)
5.Données d’entrée
Une ligne par observation : la réponse et une colonne par prédicteur ; en option une colonne d’essais (succès sur N), d’effort (offset) et des facteurs de regroupement.
Ce que la figure demande
- Une variable 0/1 à expliquer
- Les prédicteurs (1 à 12)
Format : CSV, TXT ou Excel, une ligne d’en-tête avec le nom des colonnes. La virgule ou le point décimal, le séparateur et l’encodage sont reconnus seuls ; une case vide est une valeur manquante.
Le jeu d’exemple : Pâturage et richesse au Sahel
Rôles : Acacia (0/1) expliquée par le pâturage, la pluie et la distance à l’eau.
6.Prix
5crédits
par lancement sur vos données. Chaque figure coûte 5 crédits, quelle qu’elle soit : la figure, ses tableaux, son interprétation et ses téléchargements sont compris.
| Pack | Prix du pack | Cette figure |
|---|---|---|
| Starter (50 crédits) | 500 FCFA | 50 FCFA |
| Standard (250 crédits) | 2 000 FCFA | 40 FCFA |
| Pro (700 crédits) | 5 000 FCFA | 36 FCFA |
- Gratuite sur son jeu d’exemple (paturage_sahel.csv), résultats complets : pour la découvrir avant d’importer vos données.
- Sur vos données sans assez de crédits, elle se lance quand même en aperçu flouté, débloqué ensuite pour 5 crédits sans relancer le calcul.
- Si le calcul échoue, les crédits sont rendus.
- Paiement par mobile money ; voir les packs.
Lancer « Régression logistique + ROC » sur vos données
Ou ouvrez-la gratuitement avec son jeu d’exemple pour voir chaque étape et des résultats complets avant d’importer votre fichier.